Si vous passez régulièrement par ici, vous l’avez peut-être remarqué : le dernier article date du 30 octobre. C’était la partie 14 sur le Comet X, et depuis, plus rien. Le homelab n’a pas pris feu, le rack tient debout et je n’ai pas abandonné le blog. J’avais juste la tête dans un autre projet, qui a fini par prendre toute la place.
Combien de temps exactement ? Honnêtement, je n’ai pas compté. Je m’y suis mis le soir et le week-end, à mon rythme et sans pression.
Il s’appelle Tapyr, c’est mon deuxième projet open source après Keymaker. Voici sa présentation.
Le problème : des API qui comptent vos appels#
De plus en plus d’équipements réseau se gèrent depuis le cloud : bornes Wi-Fi, switches, passerelles SD-WAN, routeurs 4G et 5G. Le constructeur fournit une console de management et souvent une API REST. Pour collecter et centraliser les métriques, c’est tentant : on interroge l’API régulièrement, on pousse tout dans Prometheus et on admire le résultat dans Grafana.
Sauf que ces API rationnent les appels et rarement d’une seule façon. Quelques exemples, tirés de la documentation des constructeurs :
- Aruba Central (plateforme classique) : 7 appels par seconde et un quota d’au moins 5 000 appels par jour, remis à zéro à minuit GMT
- Cisco Meraki : 10 requêtes par seconde par organisation, partagées avec toutes les autres applications qui utilisent l’API
- Teltonika RMS : 100 000 requêtes par mois
Imaginez un collecteur naïf qui interroge tout, toutes les minutes. Le matin (ou en début de mois), tout va bien. En milieu de journée (ou en milieu de mois), le quota est épuisé, l’API répond 429 Too Many Requests à chaque appel et tous vos équipements disparaissent des graphiques jusqu’au reset. La cause se cache dans un en-tête de réponse que personne ne regarde. Et sur un dashboard, un équipement absent est vu comme un équipement en panne.
Ajoutez à ça que chaque constructeur a son API, sa pagination et son authentification : il faut un exporter différent par constructeur, chacun avec sa façon de gérer (ou d’ignorer) les limites.
C’est dans ce contexte que Tapyr est né.
Ce que fait Tapyr#
En une phrase : Tapyr transforme les API des équipements réseau gérés dans le cloud en métriques propres, sans jamais épuiser leurs quotas.
C’est une passerelle écrite en Go, sous licence Apache 2.0, que vous hébergez vous-même. Elle interroge les API, normalise les données (mêmes conventions de labels et d’unités pour tous les constructeurs) et les livre en Prometheus ou en OTLP, vers le backend de votre choix.
Son parti pris : traiter le quota comme un budget qu’on planifie, pas comme un mur qu’on découvre en le percutant de plein fouet. Chaque appel est planifié en fonction de toutes les limites du constructeur : débits, quotas quotidiens ou mensuels, par compte ou par organisation, appels en parallèle. Quand le budget se resserre, les jobs les moins prioritaires ralentissent en premier et les jobs critiques gardent leur cadence. Une réserve reste même de côté pour les nouvelles tentatives.
Autour de ce cœur :
- Une API se décrit, elle ne se code pas. Endpoints, authentification, pagination et transformation du JSON en métriques s’écrivent en YAML et en CEL (le langage d’expressions de Google, utilisé notamment par Kubernetes). Ajouter un constructeur ne demande pas une ligne de Go.
- Un simulateur par provider, qui applique les vraies limites du constructeur, scénarios de panne compris. On peut tout essayer sans compte.
- La supervision de la supervision : Tapyr exporte ses propres métriques, dont le quota restant et son épuisement prévu.
- Une interface web en lecture seule, intégrée au binaire, pour voir ce qui tourne.
Comment ça marche#
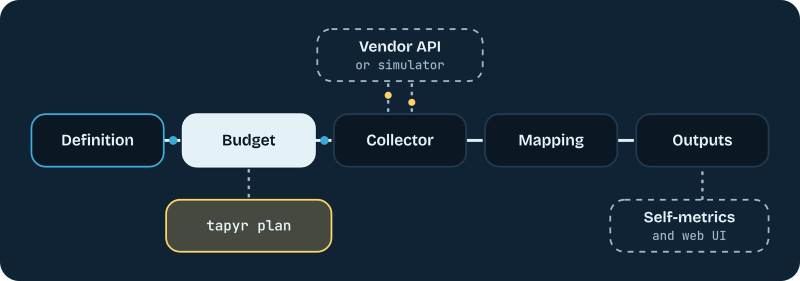
- On décrit l’API une seule fois : ses endpoints, sa pagination, la façon dont son JSON devient des métriques, et chaque limite imposée par le constructeur.
- Le moteur de budget planifie chaque appel, et calcule pour chaque job un intervalle qui tient dans les quotas. Il lit aussi les en-têtes de quota de l’API, pour tenir compte des autres applications qui puisent dans le même budget.
- Le collecteur récupère les données, suit la pagination, réessaie ce qui échoue et respecte le
Retry-Afterquand le constructeur demande de ralentir. - Le mapping transforme le JSON en métriques, avec des expressions CEL qui choisissent les éléments, calculent les valeurs et posent les labels.
- Les sorties livrent : exposition et remote write Prometheus, OTLP en HTTP et en gRPC.
Et avant même le premier appel, tapyr plan affiche ce qu’une configuration va consommer sur chaque quota et quels jobs seront ralentis pour que tout rentre.
Et le homelab dans tout ça ?#
Les lecteurs de la série Mon homelab de zéro reconnaîtront quelques noms. Mon réseau tourne sur de l’UniFi (partie 2 et partie 3) et mon backup 5G est un Teltonika (partie 4) : deux familles que Tapyr sait interroger.
D’ailleurs, Tapyr tourne en interne sur le homelab : il me sert de préprod, pour valider le projet sur mes propres API. Et si vous voulez voir à quoi il ressemble sans rien installer, une instance publique tourne aussi en démo, avec l’interface de Tapyr et son Grafana, sur des API simulées.
Côté observabilité, j’avais dessiné un Grafana unique pour tout le lab dans la partie 5 et la partie 13 a repoussé Prometheus et Grafana à plus tard. Ils sont toujours au programme.
Où en est le projet#
À ce jour, Tapyr est en version 0.4.0, sortie le 14 novembre 2026. Soyons clairs : c’est un projet 0.x. Le format de configuration peut encore changer d’une version mineure à l’autre, et chaque changement est noté dans le changelog.
Sept providers sont intégrés, chacun avec un statut de validation affiché :
| Provider | Ce qu’il couvre | Validation |
|---|---|---|
| Aruba Central (classic) | bornes, switches, passerelles | vraie plateforme |
| Cisco Meraki | Dashboard API v1 | vraie plateforme |
| Teltonika RMS | la gestion cloud des routeurs | vraie plateforme |
| Teltonika RutOS | l’API locale des routeurs | vraie plateforme |
| UniFi Site Manager | consoles, sites, équipements, métriques FAI | vraie plateforme |
| Cisco ThousandEyes | tests réseau et agents | simulateur seulement |
| Juniper Mist | bornes, switches, WAN edge | simulateur seulement |
ThousandEyes et Mist attendent encore un vrai compte pour être validés. Si vous en avez un, vos retours sont précieux.
Pour l’installation tout est disponible : image Docker, chart Helm, paquets deb et rpm, Homebrew sur macOS, et les binaires pour Linux, macOS et Windows.
L’essayer sans aucun compte#
Le plus simple, c’est la démo publique évoquée plus haut : l’interface de Tapyr et son Grafana, sur des API simulées, en lecture seule.
Si vous préférez chez vous, la même démo tourne en Docker Compose, avec les simulateurs, VictoriaMetrics et Grafana :
git clone https://github.com/kentrow/tapyr.git
cd tapyr/examples/compose
docker compose up -d
Grafana répond sur http://127.0.0.1:3000, l’interface de Tapyr sur http://127.0.0.1:9790/ui/ et les premières métriques arrivent en moins d’une minute. Tout le reste est dans la documentation.
Ce que ça m’a appris#
Avec Keymaker, j’écrivais que publier un projet, ce n’est pas juste pousser du code sur GitHub. Tapyr pousse le curseur plus loin. Keymaker est un outil d’atelier, qui tourne le temps d’une session. Tapyr, lui, est fait pour tourner en continu, chez d’autres que moi, avec leurs identifiants. Il faut donc une documentation versionnée, des releases signées, un simulateur pour que personne n’ait besoin de comptes chez sept constructeurs et une vraie honnêteté sur ce qui a été validé, et sur quoi.
La suite#
Pour Tapyr, la question est simple : quelle API devrait être la prochaine ? Le réseau est le premier cas d’usage, pas la limite : le moteur ne sait rien des réseaux, et toute API qui sert des métriques peut se décrire de la même façon. La page des idées de providers liste des pistes, du réseau à l’énergie en passant par la maison. Si une API vous manque, le formulaire de proposition des issues GitHub est fait pour ça.
Pour le blog, la série homelab reprend : la partie 15, sur le rack 10 pouces imprimé en 3D, est déjà bien avancée.
Liens utiles#
- Le site de Tapyr
- La documentation
- La démo publique
- Le dépôt sur GitHub et ses issues : retours, idées et bugs sont les bienvenus
Mon mot de la fin#
Si vous supervisez des équipements gérés dans le cloud et que vous avez déjà vu un dashboard se vider sans raison apparente, faites un tour sur le projet et n’hésitez pas à tester. Et si Tapyr vous plaît, une étoile sur le dépôt fait toujours plaisir.
À bientôt !